
简而言之,答案是肯定的,克劳德智能探测器与 chatgpt 探测器确实存在差异,但它们通常出现在探测器行为中,而不是任何有保证的获胜者中。大多数工具在它们要发现的写作特征、人工编辑后的反应以及它们的分数在实际出版过程中是否有用方面有所不同。对于 SEO 团队来说,这使得决策不再与品牌标签有关,而是更多地与工作流程适合度、误报容忍度以及草稿标记后仍进行多少人工审核有关。如果您需要更广泛的类别视图,请参阅适用于 SEO 发布商的最佳智能检测工具。
实际上,围绕 Claude 式书写构建的检测器可能会关注与针对 ChatGPT 式书写调整的检测器不同的模式。当您筛选仍接近其原始形式的文本时,这一点可能很重要。一旦内容被重写、本地化、与注释合并或被编辑润色,一切就不那么重要了。所以对于大多数出版商来说,最大的区别并不是绝对的准确性。问题在于检测器是否可以帮助您的团队做出更快、更一致的审核决策。
直接回答:Claude 和 ChatGPT 检测器有何不同
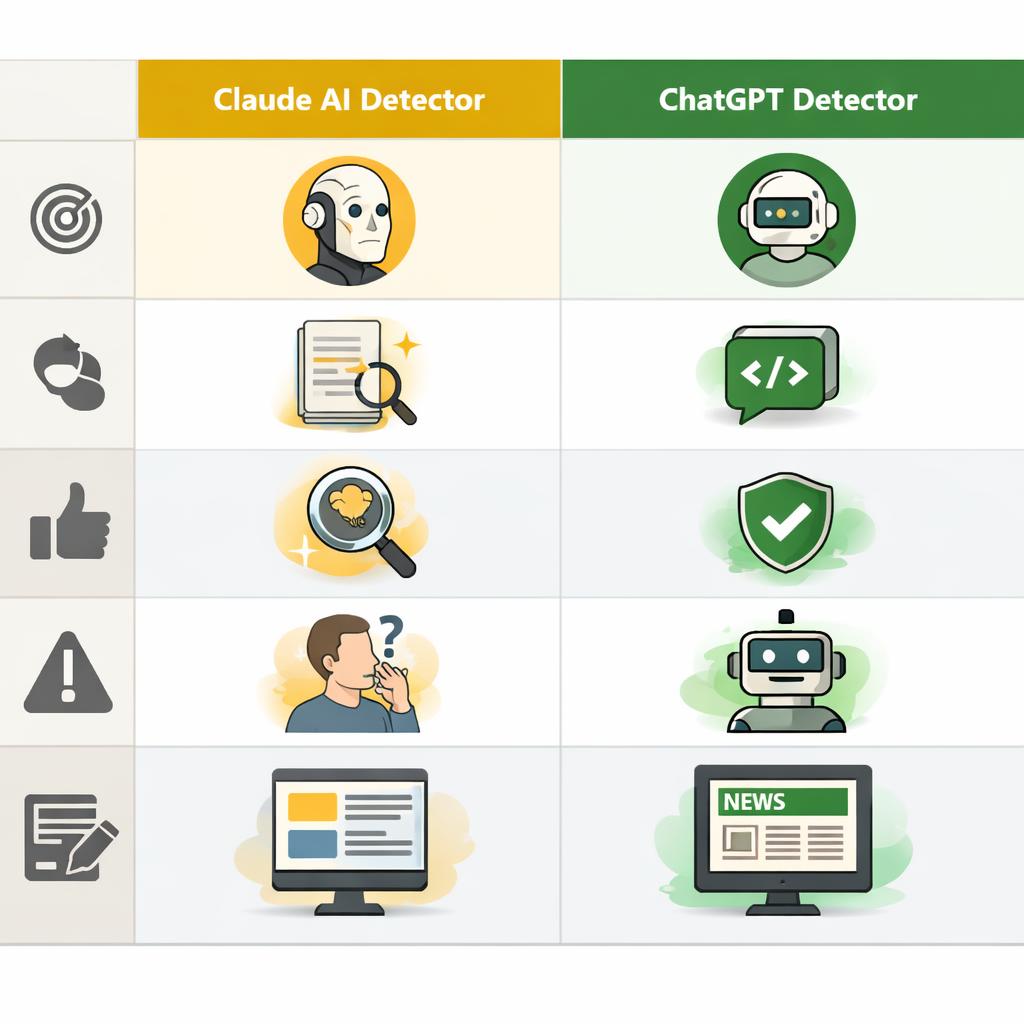
最明显的区别是调音。以 Claude 为中心的检测器通常会尝试识别通常与精美的解释性长篇写作相关的特征,而以 ChatGPT 为中心的检测器可能对对话结构、提示形状格式或可预测的响应模式更敏感。这些是趋势,而不是规则,但它们会影响标记的内容和漏掉的内容。
另一个区别是乐谱设计。一些工具尝试将文本标记为与特定源系列匹配,而其他工具则为机器编写的文本输出更广泛的可能性分数。对于编辑团队来说,更广泛的评分可以更容易地应用于混合草稿。当您的政策问题范围较小时,来源系列标签可能会很有用,例如检查提交的内容是否比另一个已知的写作来源更相似。无论哪种情况,分数都是审查的信号,而不是作者身份或意图的证明。
每个探测器通常调整捕捉的内容
以克劳德为中心的检测器可能会对较长段落的平滑过渡、平衡解释和结构化推理做出更强烈的反应。以 ChatGPT 为重点的检测器可能更有可能注意到熟悉的即时响应节奏、大量列表的组织、重复的框架或感觉公式化的结论模式。这并不意味着每个探测器只能在一个源上工作。事实上,许多工具仍然依赖于更广泛的规律性,例如句子的可预测性、重复的措辞或语法的低变化。
这种重叠就是结果可能变得混乱的原因。以 Claude 为中心的工具仍可能标记类似于 ChatGPT 输出的文本,反之亦然。对于短文、经过大量编辑的文章、翻译的页面或故意重写以听起来更独特的内容,两者都可能变得不那么可靠。对于出版商来说,实际的收获很简单:检测器类别可能不同,但它们的限制也经常重叠。
哪种检测器适合您的 SEO 发布工作流程
如果您的团队需要对贡献者提交的内容进行快速的首次筛选,那么通用检测器或灵活的特定于模型的选项可能就足够了。如果您已经知道可能的源系列并且需要有针对性的策略检查,那么比较以 Claude 为中心的检测器和以 ChatGPT 为中心的检测器值得您花时间,因为调整可能会更好地匹配您提出的问题。真正的问题是您的工作流程是否会询问“这看起来是机器编写的吗?”或者“这看起来像是来自这种类型的来源吗?”
内容类型也很重要。产品综述、位置页面、联属网络公司比较和模板化支持内容通常会引发更多错误信号,因为它们自然会重复结构和措辞。专家评论、观点文章和原创报告可能会产生更清晰的评论信号。混合作者页面尤其困难,因为它们结合了样式、修订和编辑清理。在这些情况下,特定于模型的检测可能会很快失去价值,稳定的审查过程变得比狭窄的标签更重要。
特定于模型的检测何时有帮助,何时没有
当文本仍然相当原始、可能的来源对您的策略很重要并且您的编辑希望在更深入的审查之前进行有针对性的分类时,特定于模型的检测最有帮助。它对于外包提交、早期草稿筛选或比较尚未实质性重写的文本的受控测试非常有用。在这些情况下,调谐到一个源系列的检测器可以提供比广泛分类器更清晰的信号。
当文章经过几轮编辑、将研究与人工评论相结合,或者随着时间的推移由多个贡献者刷新时,它的帮助就较小。到那时,分数可能只会告诉您仍然存在一些自动写作模式。它不会告诉您该页面是否有用、原创、准确或可能在搜索中表现良好。这就是为什么这些工具值得那些需要更快筛选的出版商进行比较,但不能替代编辑标准、事实检查或质量审查。
如何在不过度信任分数的情况下比较检测器
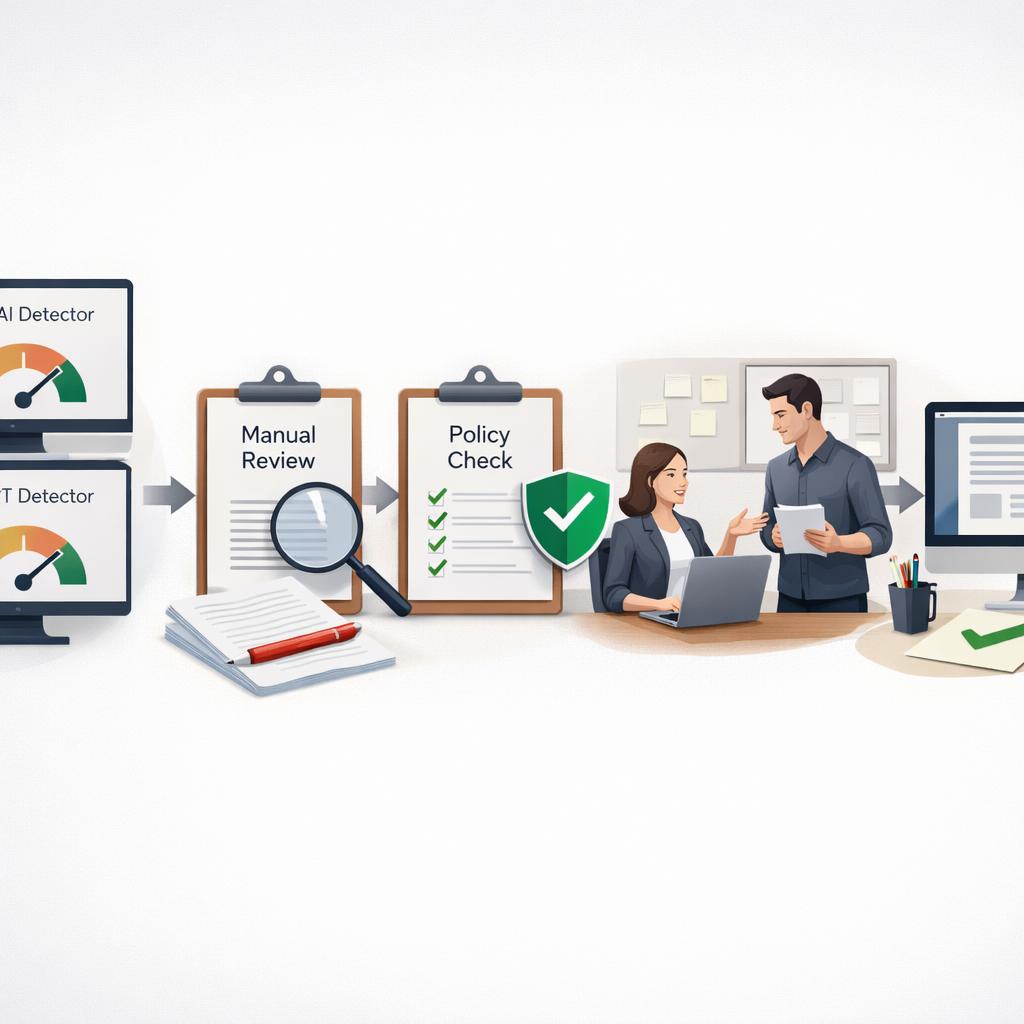
比较工具的最佳方法是在您自己的示例集上测试它们,而不是依赖供应商消息传递或孤立的演示。包括未修改的生成草稿、经过大量编辑的版本、已发布的页面、重写的部分和混合作者的文章。然后,不仅比较标题分数,还比较一致性、误报以及输出是否真正改变了编辑下一步的操作。这也是检测器测试应与更广泛的内容审核工作流程联系起来的地方。
一个简单的拟合矩阵可以帮助:
- 最适合:原始提交、来源已知草稿、狭窄的政策检查
- 可能适合:轻度编辑的商业页面、外包内容审查、出版前分类
- 弱适合:混合作者更新、翻译文章、大量重写的帖子
- 不要单独依赖:最终质量批准、原创性判断、排名预测
检查结果时,将测试实际支持的内容与不支持的内容分开。主要发现是在您的工作流程中明显有用的行为,例如轻微编辑后的稳定评分或页面类型上较少的误报。次要发现有帮助,但不太具有决定性,例如来源家族标签。探索性发现是值得关注的模式,而不是在整个团队中推出工具的理由。
发布前发布商的简单测试标准
保持试点小而实用。在真实格式上测试每个检测器,检查结果在人工编辑后是否仍然可用,并注意标记的分数导致有意义的编辑操作的频率。包括边缘情况,如简短的介绍、引用的段落、重写为散文的比较副本,以及更新的页面,旧的部分保持不变。仅在未修改的草稿上看起来很强大的工具可能无法在真实的发布条件下生存。
寻找实用的可靠性而不是完美的分类。优秀的候选者会清楚地解释分数,支持可重复的审核规则,并帮助编辑决定下一步要检查的内容。较弱的候选者会制造噪音,在小幅重写后发生巨大变化,或鼓励过度自信。如果您在这个领域比较第一方或品牌检测器,那么只有当它减少前期流程摩擦、适合您团队实际进行的编辑量并提供审阅者可以一致应用的结果时才值得考虑。在选择之前,请将分数稳定性、误报率、混合作者行为和文档清晰度与您自己的样本集进行比较。
结论
核心判断是,当您的工作流程依赖于源系列模式匹配时,claude smart detector 与 chatgpt detector 的差异最为重要,而当内容主要针对更广泛的机器编写信号进行大量编辑、混合或审查时,这些差异就不那么重要了。换句话说,这取决于您的用例。如果您需要窄源检查,特定于模型的调整可能会有所帮助。如果您需要跨多种页面类型进行可靠的编辑分类,那么分数稳定性和可用性通常更重要。
在推出之前,使用已发布的页面、原始草稿、重写的示例和混合作者内容进行小型比较。检查哪种工具提供最有用的信号,哪种工具产生的误报最少,以及编辑后每个分数的保持情况。然后在扩大使用之前查看官方产品详细信息和您的内部审核规则。如果您接下来想比较更广泛的类别,请访问 SEO 发布商的最佳智能检测工具。
常见问题解答
Claude 检测器比 ChatGPT 检测器更准确吗?
有时,但只有当文本仍然类似于探测器经过调整以识别的源系列时。一旦草稿经过深度编辑、与人类写作合并或翻译,这种优势就会迅速缩小。准确性还取决于您的内容组合、审核阈值以及您的团队是否喜欢更少的误报或更积极的标记。
SEO 发布商需要特定模型检测器还是通用检测器?
这取决于用例。特定于模型的检测器可用于狭窄的策略检查或以源为中心的筛选。当您需要对多种草稿类型进行广泛的编辑分类时,通用检测器可能更适合。对于混合作者工作流程,可用性和分数一致性通常比非常具体的标签更有价值。
编辑文章中的 Claude 和 ChatGPT 内容检测有何区别?
在编辑过的文章中,差距往往会变得更小。两种检测器类型仍可能注意到机器写入的模式,但在大量重写后都无法可靠地识别特定的源系列。这就是为什么编辑的内容应该通过检测器输出以及手动检查的原创性、事实支持、语音一致性和读者实用性进行审查。
SEO 发布商的最佳智能检测工具何时成为合理的下一个资源?
当您完成头对头比较并需要更广泛地了解检测器类别、工作流程适合性和推出标准时,下一步就是正确的选择。它对于构建审核流程或缩小候选名单的团队很有用。如果您仍未定义策略目标、样本集或接受标准,请先执行此操作,然后使用 SEO 发布商的最佳智能检测工具来比较更广泛的选项。


